orchestrata_tools.context.project_context
Reference › orchestrata_tools › context › project_context
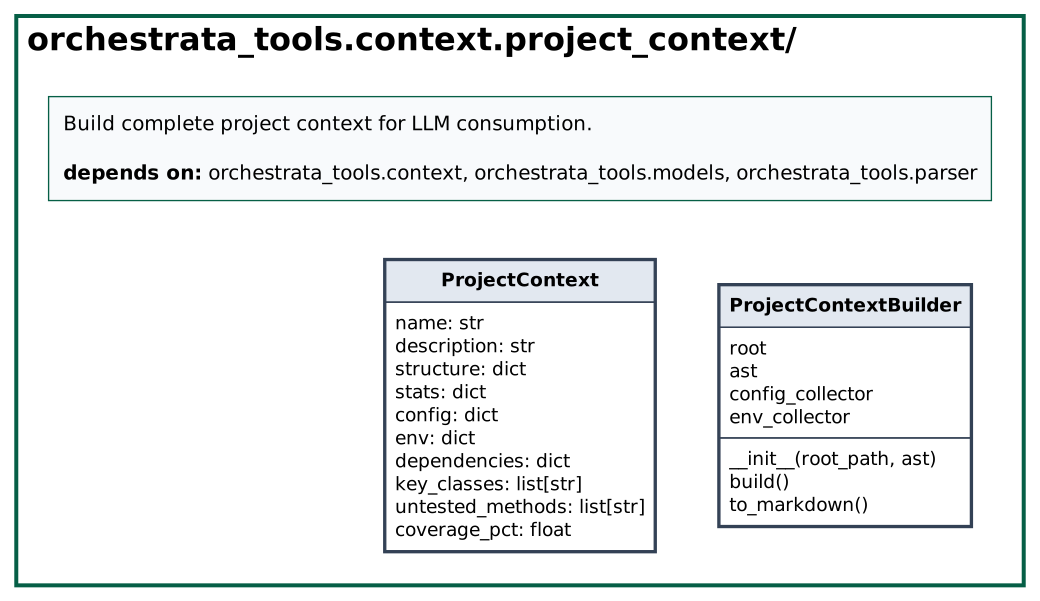
This module builds the complete project description that prompt_builder feeds to an LLM. ProjectContext is a dataclass holding the name, description, source structure, statistics, configuration, environment, dependencies, key classes, untested methods and a coverage percentage.
ProjectContextBuilder takes a project root and an optional ASTCodebase. build takes the name from the AST or the directory name, and the description from the first line of README.md. It lists the packages under src, and gets configuration from config_collector and environment from env_collector. With an AST it also adds statistics, a dependency summary from dependency_summary, and the ten largest classes from the index as key classes. The untested-method list and coverage fields are declared but build does not fill them. to_markdown renders the context as a Markdown document.
At a glance
| Source | src/orchestrata_tools/context/project_context.py |
| Lines of code | 157 |
| Classes | 2 |
| Functions | 0 |
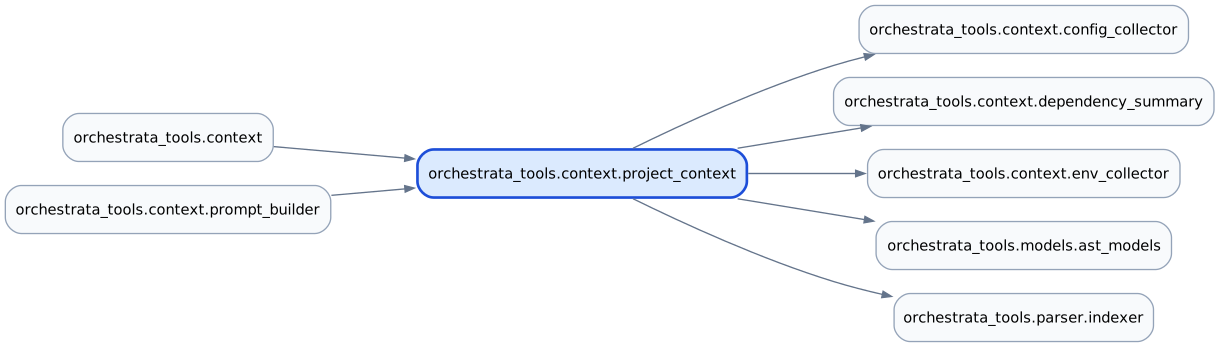
| Imports (internal) | orchestrata_tools.context.config_collector, orchestrata_tools.context.dependency_summary, orchestrata_tools.context.env_collector, orchestrata_tools.models.ast_models, orchestrata_tools.parser.indexer |
| Imported by | orchestrata_tools.context, orchestrata_tools.context.prompt_builder |
| Tests that import it | tests/test_orchestrata_tools.py, tests/test_orchestrata_tools_reviewer_query_indexer.py |
Class diagram
Dependency diagram
API
Classes
ProjectContext (dataclass)
Decorators: dataclass · Line 18
Complete project description for LLM context.
| Attribute | Type | Default |
|---|---|---|
name |
str |
'' |
description |
str |
'' |
structure |
dict |
field(default_factory=dict) |
stats |
dict |
field(default_factory=dict) |
config |
dict |
field(default_factory=dict) |
env |
dict |
field(default_factory=dict) |
dependencies |
dict |
field(default_factory=dict) |
key_classes |
list[str] |
field(default_factory=list) |
untested_methods |
list[str] |
field(default_factory=list) |
coverage_pct |
float |
0.0 |
ProjectContextBuilder
Line 33
Build comprehensive project context from AST and filesystem.
| Method | Signature | Summary |
|---|---|---|
__init__ |
__init__(root_path: str | Path, ast: ASTCodebase | None = None) |
|
build |
build() -> ProjectContext |
|
to_markdown |
to_markdown() -> str |
Render project context as markdown for LLM prompts. |
Source
"""Build complete project context for LLM consumption."""

from __future__ import annotations

from dataclasses import dataclass, field
from pathlib import Path
from typing import TYPE_CHECKING

from orchestrata_tools.context.config_collector import ConfigCollector
from orchestrata_tools.context.dependency_summary import DependencySummarizer
from orchestrata_tools.context.env_collector import EnvCollector

if TYPE_CHECKING:
    from orchestrata_tools.models.ast_models import ASTCodebase


@dataclass
class ProjectContext:
    """Complete project description for LLM context."""

    name: str = ""
    description: str = ""
    structure: dict = field(default_factory=dict)
    stats: dict = field(default_factory=dict)
    config: dict = field(default_factory=dict)
    env: dict = field(default_factory=dict)
    dependencies: dict = field(default_factory=dict)
    key_classes: list[str] = field(default_factory=list)
    untested_methods: list[str] = field(default_factory=list)
    coverage_pct: float = 0.0


class ProjectContextBuilder:
    """Build comprehensive project context from AST and filesystem."""

    def __init__(self, root_path: str | Path, ast: ASTCodebase | None = None):
        self.root = Path(root_path)
        self.ast = ast
        self.config_collector = ConfigCollector(self.root)
        self.env_collector = EnvCollector(self.root)

    def build(self) -> ProjectContext:
        ctx = ProjectContext()

        # Basic info
        ctx.name = self.ast.name if self.ast else self.root.name
        readme = self.root / "README.md"
        if readme.exists():
            with open(readme) as f:
                lines = f.readlines()
                ctx.description = lines[0].strip("# \n") if lines else ""

        # Stats
        if self.ast:
            ctx.stats = {
                "modules": len(self.ast.modules),
                "classes": len(self.ast.all_classes),
                "methods": len(self.ast.all_methods),
                "functions": len(self.ast.all_functions),
                "loc": self.ast.total_loc,
            }

        # Structure
        src_dir = self.root / "src"
        if src_dir.exists():
            packages = [d.name for d in src_dir.iterdir() if d.is_dir()]
            ctx.structure = {"source_packages": packages}

        # Config
        config = self.config_collector.collect()
        ctx.config = {
            "python_version": config.python_version,
            "build_system": config.build_system,
            "test_framework": config.test_framework,
            "linter": config.linter,
            "formatter": config.formatter,
        }

        # Environment
        env = self.env_collector.collect()
        ctx.env = {
            "has_docker": env.has_docker,
            "has_docker_compose": env.has_docker_compose,
            "infrastructure": env.infrastructure,
            "env_files": env.env_files,
        }

        # Dependencies
        if self.ast:
            dep_summary = DependencySummarizer(self.ast).summarize()
            ctx.dependencies = {
                "internal_modules_count": len(dep_summary.internal_modules),
                "external_packages": dep_summary.external_packages[:20],
                "stdlib_imports": dep_summary.stdlib_imports[:10],
            }

        # Key classes (largest by method count)
        if self.ast:
            from orchestrata_tools.parser.indexer import ASTIndex

            index = ASTIndex(self.ast)
            largest = index.largest_classes(10)
            ctx.key_classes = [name for name, _ in largest]

        return ctx

    def to_markdown(self) -> str:
        """Render project context as markdown for LLM prompts."""
        ctx = self.build()
        lines = [
            f"# Project: {ctx.name}",
            "",
            f"{ctx.description}",
            "",
            "## Structure",
            "",
            f"- Source packages: {', '.join(ctx.structure.get('source_packages', []))}",
            "",
            "## Statistics",
            "",
        ]
        for key, val in ctx.stats.items():
            lines.append(f"- {key}: {val}")

        lines.extend(
            [
                "",
                "## Configuration",
                "",
                f"- Python: {ctx.config.get('python_version', 'unknown')}",
                f"- Build: {ctx.config.get('build_system', 'unknown')}",
                f"- Tests: {ctx.config.get('test_framework', 'unknown')}",
                f"- Linter: {ctx.config.get('linter', 'unknown')}",
                f"- Formatter: {ctx.config.get('formatter', 'unknown')}",
                "",
                "## Dependencies",
                "",
                f"- External packages: {', '.join(ctx.dependencies.get('external_packages', []))}",
                "",
                "## Key Classes",
                "",
            ]
        )
        for cls in ctx.key_classes:
            lines.append(f"- {cls}")

        lines.extend(
            [
                "",
                "## Coverage",
                "",
                f"- Method coverage: {ctx.coverage_pct}%",
                "",
            ]
        )

        return "\n".join(lines)